Dai disservizi Microsoft ai voli bloccati negli Stati Uniti, una settimana di blackout e allarmi riapre il dibattito sulla nostra dipendenza dalla tecnologia e sull’assenza di un piano B.
IN BREVE
Settimana segnata da disservizi Microsoft e blocco dei voli USA, che mettono a nudo la fragilità dei sistemi digitali.
Aziende e istituzioni senza alternative tra case connesse poco sicure e allarmi scolastici: dov’è il piano B?
Cresce anche la dipendenza dall’IA: figli che si affidano ai chatbot e genitori timorosi di essere sostituiti.
Microsoft in tilt e voli in stallo: perché manca ancora un vero “piano B” nel digitale
Un blackout tecnologico e migliaia di persone ferme a terra: basta un fornitore critico che si inceppa e il sistema si blocca. Non è sfortuna: è progettazione carente. E se capitasse anche alla tua azienda? Qui sta la domanda scomoda.
Cosa è successo: il corto circuito tra IT e trasporti
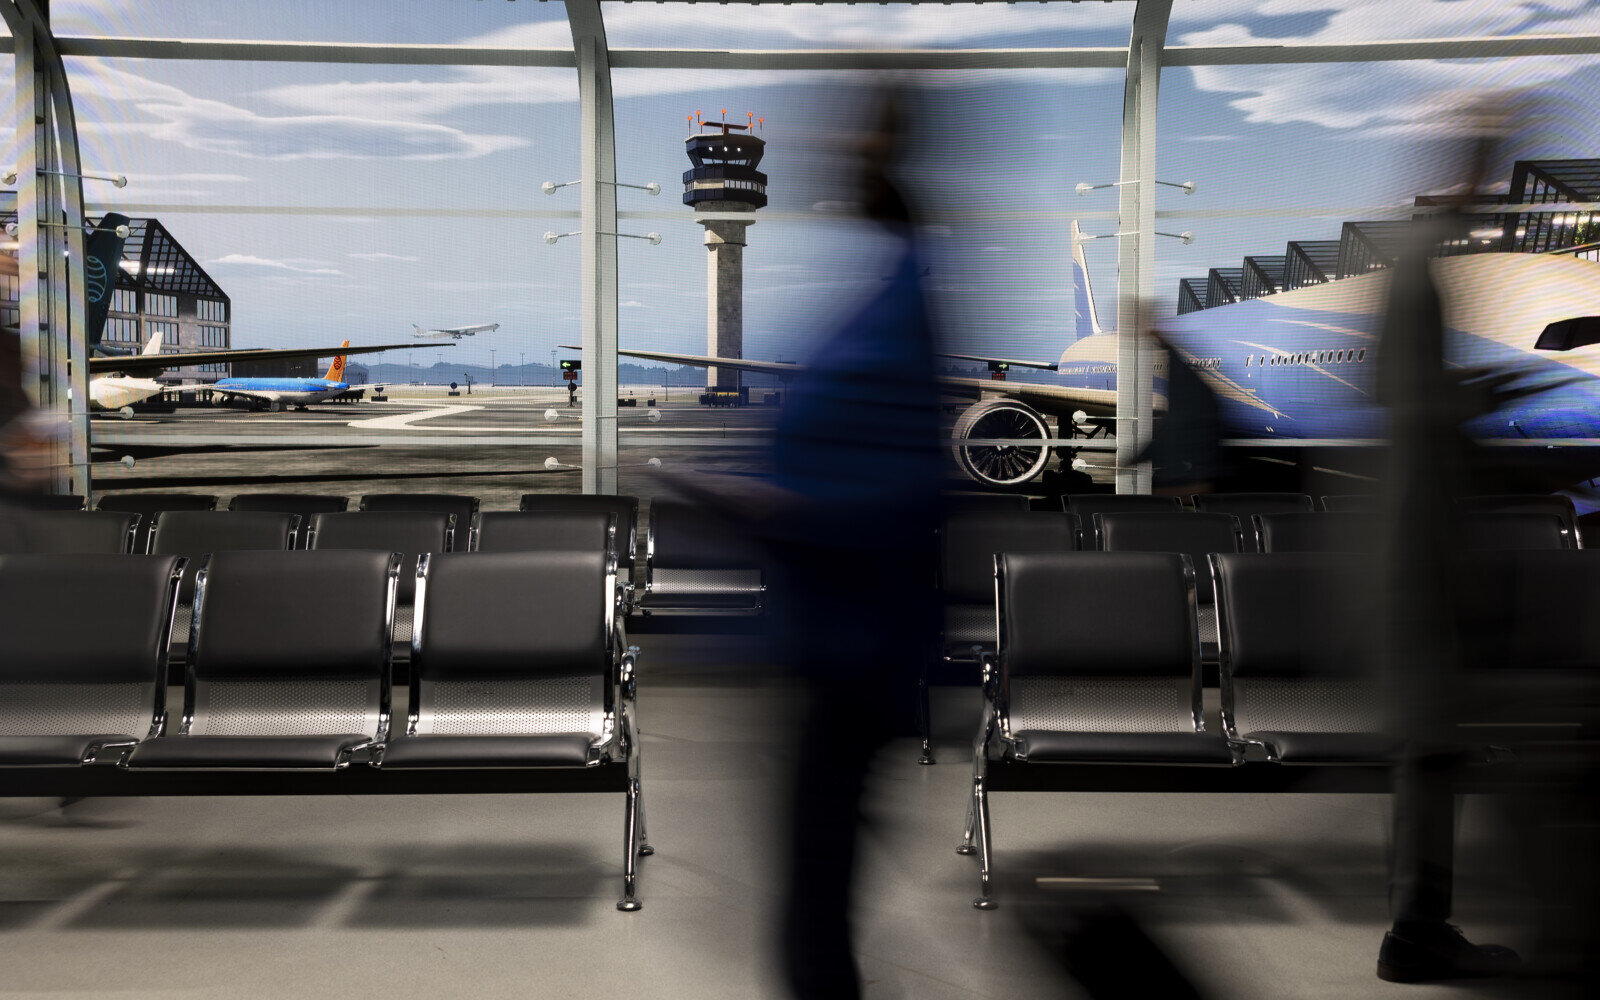
Nelle ultime ore, tra cancellazioni e ritardi a catena, il traffico aereo USA ha subito un impatto pesante. Secondo gli aggiornamenti riportati da la diretta di Repubblica, la situazione ha messo in evidenza quanto il sistema sia fragile quando un fornitore tecnologico centrale va in down. Da qui il punto cruciale: l’ecosistema Microsoft e i servizi collegati sono così pervasivi da trasformare un disservizio IT in un problema infrastrutturale reale.
Non serve entrare nel dettaglio tecnico per capire il quadro: procedure, check-in, turnazioni, sistemi di sicurezza e comunicazione operano su piattaforme integrate. Se uno snodo salta, l’effetto domino diventa inevitabile. Il problema non è “il bug”, ma la dipendenza cieca da un unico punto di verità.
Quando crolla un fornitore critico: il prezzo della monocultura
La monocultura tecnologica è comoda, finché non esplode
Standardizzare su un unico vendor taglia costi, tempi e complessità. Ma crea un rischio sistemico: se cade lui, cadi anche tu. È successo nell’IT, succede nella logistica, succede nel finance. E adesso lo vediamo a livello di trasporti: un down software si traduce in gate chiusi e passeggeri fermi.
Le dipendenze nascoste che non monitori
Molte organizzazioni non mappano davvero le loro dipendenze: librerie, agent, plugin, identity provider, tool di sicurezza. Risultato: l’“albero delle cause” è opaco. Quando scatta la crisi, non sai cosa isolare, cosa spegnere, cosa riavviare. Il tempo vola, e con lui la fiducia degli utenti.
Il piano B che non c’è (o non è stato provato)
Continuità operativa: RTO e RPO non sono slide
Recovery Time Objective e Recovery Point Objective devono tradursi in procedure pratiche: chi fa cosa al minuto 1, 5, 15, 60 dell’incidente. Se non esistono runbook eseguibili e testati, resteranno parole. Ogni minuto in più significa più voli a terra e più clienti arrabbiati.
Ridondanza vera: multi-cloud, multi-vendor, fallback offline
Ridondare non vuol dire “copiare i dati”. Significa:
- Multi-cloud e multi-vendor: servizi core replicati su provider diversi, con switch automatico o semiautomatico.
- Federazione delle identità: identity e autenticazione con percorsi alternativi se un IdP cade.
- Modalità degradate: check-in, boarding e turni operativi eseguibili offline per finestre limitate.
- Dati locali critici: snapshot firmate e sincronizzate per continuare servizi minimi essenziali.
Procedure manuali e formazione, non improvvisazione
Il “manual mode” non si inventa il giorno della crisi. Va scritto, semplificato e provato in esercitazioni periodiche. Dal personale al desk fino al centro operativo: chi comunica, con quali messaggi, che priorità seguire, quando bloccare e quando ripartire in sicurezza.
Lezioni per aziende, PA e PMI
Non serve essere una compagnia aerea per imparare qualcosa. Ecco le mosse concrete da mettere in cantiere subito:
- Mappa delle dipendenze: inventario vivo di applicazioni, fornitori, integrazioni e componenti di sicurezza. Senza mappa non c’è recovery.
- Runbook di incident response: scenari per down di provider, attacchi, errori di aggiornamento, blackout. Chi decide, cosa si spegne, cosa resta attivo.
- Test di failover trimestrali: prove tabletop e tecniche con metriche chiare. Se non lo testi, non funziona.
- Canali di comunicazione ridondanti: status page esterna, SMS, email, social. Messaggistica chiara su estensione, impatti e ETA.
- Clausole contrattuali con i vendor: SLO misurabili, penali, audit indipendenti, accesso ai log, esportabilità dei dati e uscita dal lock-in.
- Modalità operative degradate: processi minimi essenziali documentati per vendite, assistenza e operations.
- Osservabilità end-to-end: telemetria su applicazioni, rete e dipendenze esterne per capire dove si rompe davvero.
- Formazione e rotazione ruoli: tutti devono saper gestire l’emergenza, non solo “quelli dell’IT”.
L’impatto per viaggiatori e utenti: cosa aspettarsi e come reagire
Quando un fornitore centrale va giù, il ripristino può richiedere ore (o giorni). Tradotto per chi viaggia: code, riprotezioni, cambi di gate, assistenza sotto stress. Alcuni consigli utili:
- App e canali ufficiali: controlla notifiche della compagnia e dell’aeroporto, non solo i social.
- Piano alternativo: valuta tratte via treno o voli con scali diversi se la situazione si prolunga.
- Documenta i disagi: email, ricevute, screenshot per eventuali rimborsi.
- Bagaglio smart: traccia bagagli con tag e porta con te essenziali per eventuali attese lunghe.
Il messaggio di fondo: la resilienza è una scelta, non un caso
Questa ennesima crisi dimostra che l’affidabilità non nasce da un “grande fornitore”, ma da architetture pensate per fallire in modo sicuro e ripartire in fretta. Se il tuo business dipende da un unico punto, non è un business: è un azzardo.
Per il contesto aggiornato sul blocco dei voli e gli sviluppi in tempo reale, puoi leggere anche la diretta di Repubblica.
👉 Per scoprire tutti i dettagli e l’opinione personale di Mario Moroni, ascolta la puntata completa su Spotify.